

Mein neues Buch
Souveräne KI
Strategie und Aufbau der eigenen Open-Source-Infrastruktur
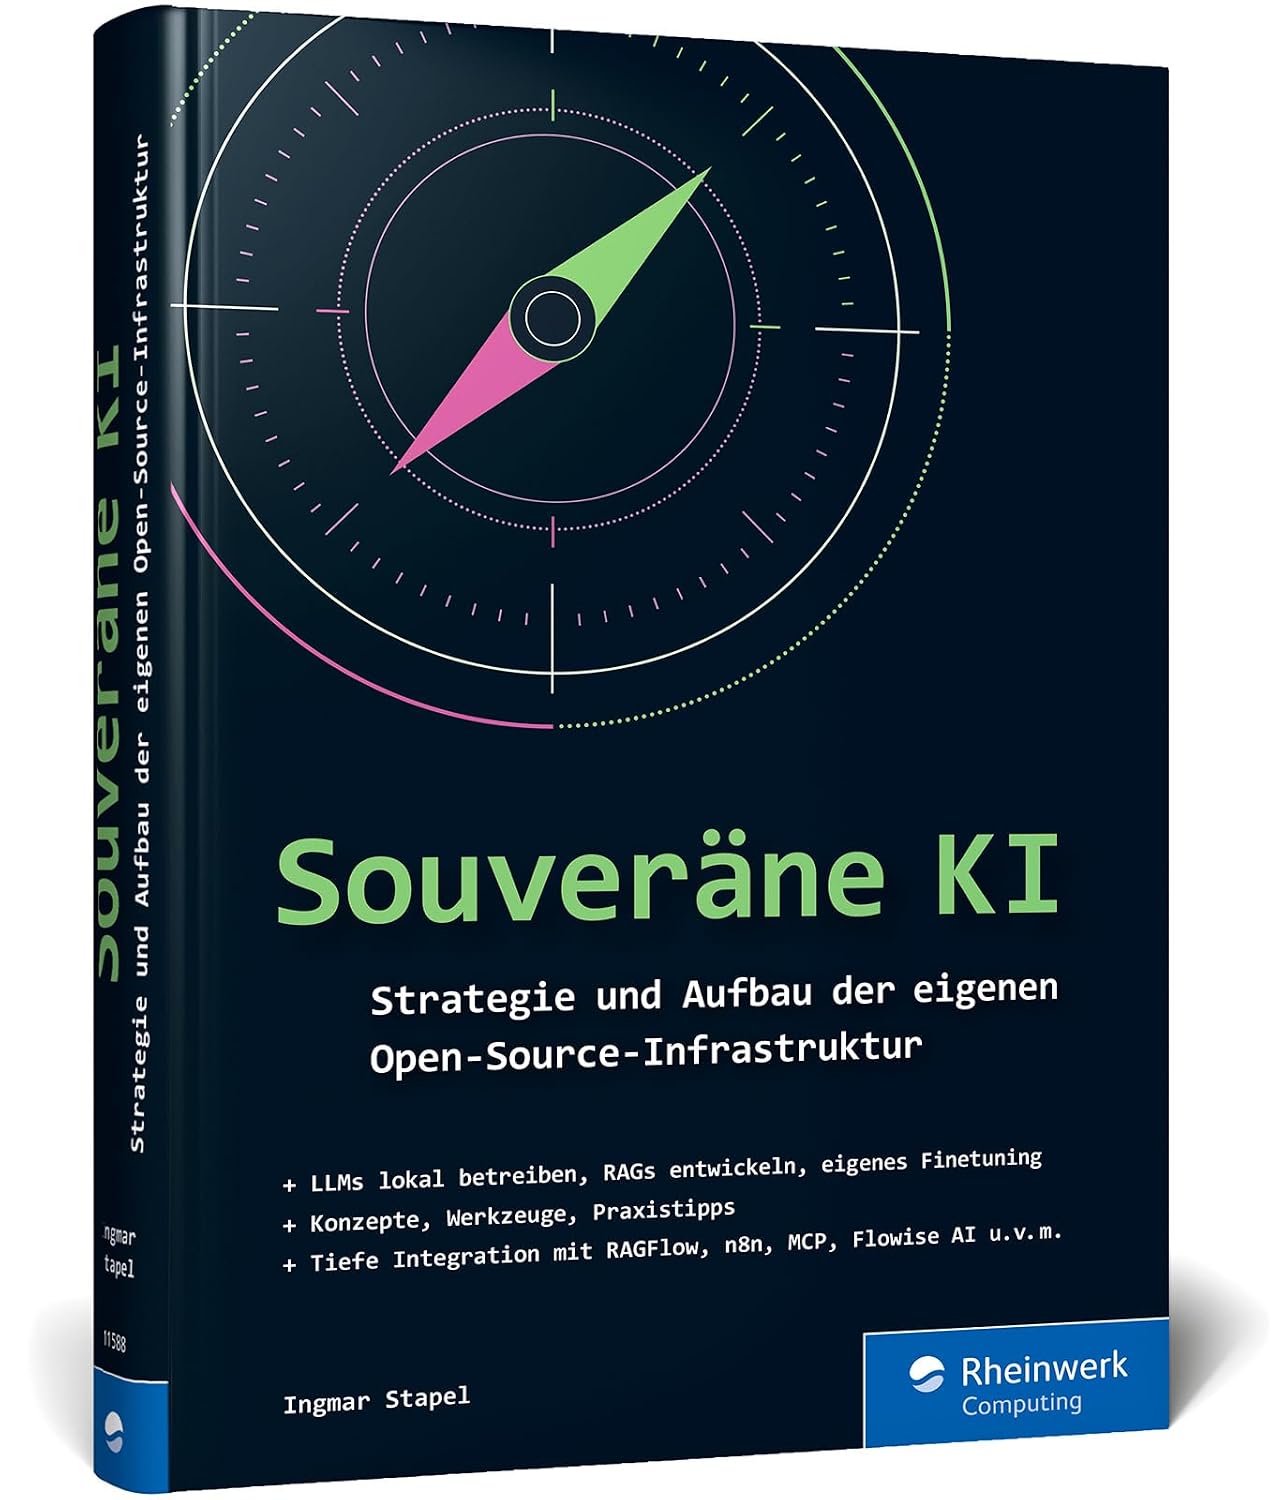
Eigene LLMs betreiben, unabhängig von der Cloud. Von der Hardware bis zum laufenden System.
Jetzt bei Amazon bestellenRoboter-Autos mit dem ESP32
Bauen, programmieren, steuern

Vom ersten Chassis bis zur WLAN-Steuerung. Schritt für Schritt zum eigenen Roboter-Auto.
Jetzt bei Amazon bestellenBuch und E-Book, Rheinwerk Verlag
Werbung / Affiliate-Link
- NVIDIA DGX Spark: Qwen3.8-27B mit SGLang und Docker Compose aufsetzen
 Nach meiner vLLM-Serie auf dem Dual-A6000-Server wollte ich wissen, wie sich Qwen3.8-27B auf der NVIDIA DGX Spark schlägt. Mein Ziel: ein lokales Modell als Backend für OpenCode, mit dem ich ESP32-Firmware schreiben, bauen und flashen lasse. Der Plan war zunächst vLLM. Am Ende ist es SGLang geworden. Warum, und wie die Installation Schritt für Schritt… Weiterlesen: NVIDIA DGX Spark: Qwen3.8-27B mit SGLang und Docker Compose aufsetzen
- Qwen3.8-27B auf zwei RTX A6000: BF16, INT4 und MTP im llama-benchy-Vergleich
 In diesem Beitrag vLLM auf zwei RTX A6000 installieren: Treiber, Setup und erster Start mit Qwen3.8-27B habe ich vLLM auf zwei RTX A6000 eingerichtet und drei Varianten von Qwen3.8-27B heruntergeladen. Volles BF16, eine INT4-Quantisierung und eine INT4-Variante mit MTP für Speculative Decoding. Nach einem Kommentar auf LinkedIn kam noch eine vierte dazu, eine GPTQ-INT4-Variante, die… Weiterlesen: Qwen3.8-27B auf zwei RTX A6000: BF16, INT4 und MTP im llama-benchy-Vergleich
- vLLM optimieren: Quantisierung, Multi-GPU-Troubleshooting und Agentenbetrieb mit Qwen3.8-27B
 Im ersten Teil habe ich vLLM auf meinen zwei RTX A6000 installiert und Qwen3.8-27B im vollen BF16 zum Laufen gebracht. Das funktionierte, aber im Alltag hat mich das Ergebnis nicht überzeugt. Beide Karten waren permanent belegt, nur um ein einziges Modell über Tensor Parallel zu bedienen, und beim agentischen Coden mit OpenCode fühlte sich das… Weiterlesen: vLLM optimieren: Quantisierung, Multi-GPU-Troubleshooting und Agentenbetrieb mit Qwen3.8-27B
- vLLM auf zwei RTX A6000 installieren: Treiber, Setup und erster Start mit Qwen3.8-27B
 vLLM ist eine schnelle Inferenz-Engine für lokale Sprachmodelle. In diesem Beitrag richte ich das Qwen3.8-27B Modell auf zwei RTX A6000 ein. Der Hauptgrund, warum ich von Ollama jetzt einmal weggehen möchte, ist das agentische Entwickeln von Software mit Qwen3.8-27B. Und ich kann nur bei vLLM das Reasoning etwas beschränken, was bei Ollama so nicht möglich… Weiterlesen: vLLM auf zwei RTX A6000 installieren: Treiber, Setup und erster Start mit Qwen3.8-27B
- Souveräne KI: Mein neues Buch ist da
 Es ist da. Mein neues Buch „Souveräne KI“ ist im Rheinwerk Verlag erschienen und wird seit Ende August ausgeliefert. Die ersten Exemplare sind bereits bei Lesern angekommen. Die Idee zum Buch entstand hier auf dem Blog und im Sommerurlaub 2025. Über die Jahre habe ich Ollama-Server aufgesetzt, Open WebUI eingerichtet, Stable Diffusion und Stable Audio… Weiterlesen: Souveräne KI: Mein neues Buch ist da
Ein toller Guide der leicht zugänglich und verständlich ist. Perfekt für ein kleines Side-Project geeignet. Aktuell half mir noch mein…
Thank you for this great tutorial, could you share n8n workflow and comfyui workflow please?
Hallo Anton, die Meldung besagt das in meinem Beisiel Methoden verwendet werden die veraltet (deprecated) sind. Also müsstest Du die…
Danke für das Tool! Ich habe erst kürzlich angefangen mich mit der Thematik zu beschäftigen und bin für meine Erwartungen…
Hallo, ich habe ihre Anleitung befolgt und bekomme im letzten Schritt leider immer folgende Meldung im Terminal: bash <(wget -qO-…