
TensorRT-LLM Pipeline: Persistente Engines bauen mit FP16 und FP8
Im zweiten Teil habe ich TensorRT-LLM im Docker-Container aufgesetzt und mit TinyLlama validiert,...
Weiterlesen
Im zweiten Teil habe ich TensorRT-LLM im Docker-Container aufgesetzt und mit TinyLlama validiert,...
Weiterlesen
Mein neues Buch
Souveräne KI
Strategie und Aufbau der eigenen Open-Source-Infrastruktur
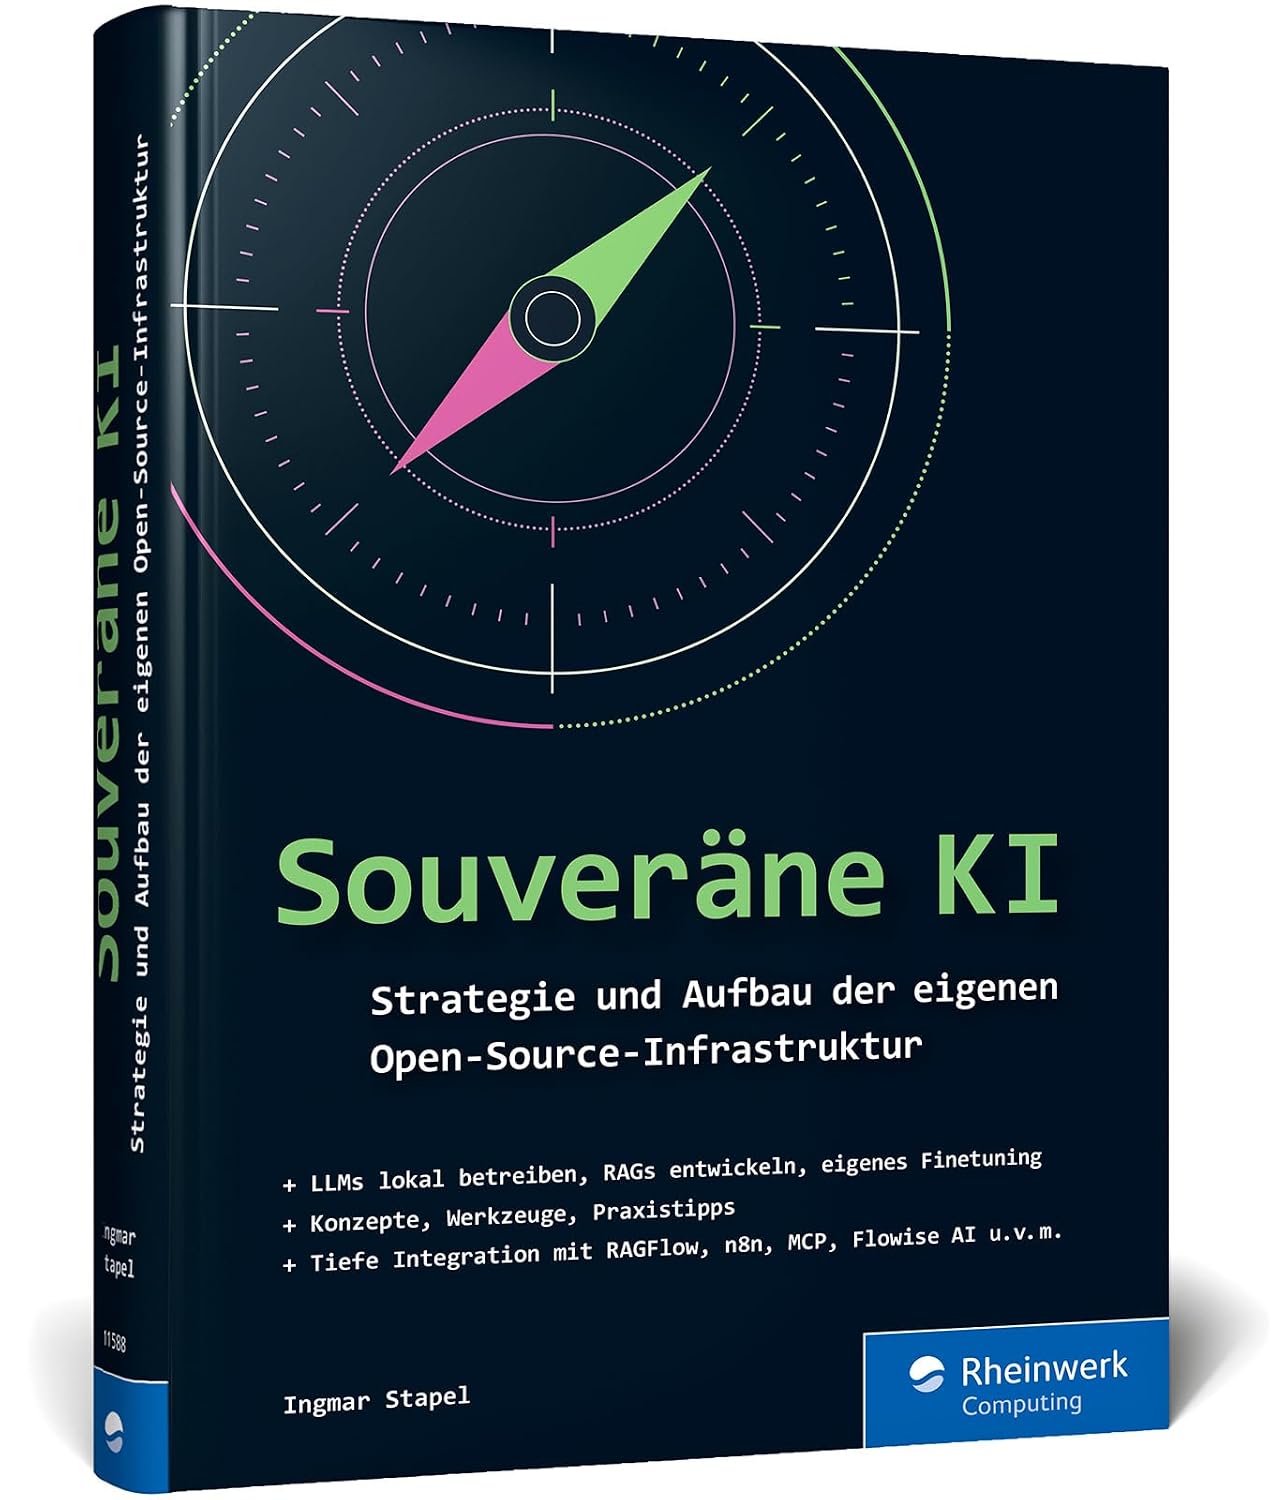
Eigene LLMs betreiben, unabhängig von der Cloud. Von der Hardware bis zum laufenden System.
Jetzt bei Amazon bestellenRoboter-Autos mit dem ESP32
Bauen, programmieren, steuern

Vom ersten Chassis bis zur WLAN-Steuerung. Schritt für Schritt zum eigenen Roboter-Auto.
Jetzt bei Amazon bestellenBuch und E-Book, Rheinwerk Verlag
Werbung / Affiliate-Link
Ein toller Guide der leicht zugänglich und verständlich ist. Perfekt für ein kleines Side-Project geeignet. Aktuell half mir noch mein…
Thank you for this great tutorial, could you share n8n workflow and comfyui workflow please?
Hallo Anton, die Meldung besagt das in meinem Beisiel Methoden verwendet werden die veraltet (deprecated) sind. Also müsstest Du die…
Danke für das Tool! Ich habe erst kürzlich angefangen mich mit der Thematik zu beschäftigen und bin für meine Erwartungen…
Hallo, ich habe ihre Anleitung befolgt und bekomme im letzten Schritt leider immer folgende Meldung im Terminal: bash <(wget -qO-…