
Im ersten Artikel dieser Reihe habe ich beschrieben, warum ich mir einen digitalen Begleiter selbst baue. Ein Gerät für ältere Menschen, das zuhört, sich erinnert und antwortet. Mit einer klaren Vorgabe: Alles läuft im eigenen Haus, innerhalb der Familie auf lokaler Hardware.
Für den digitalen Begleiter war es mir wichtig das dieser die Stimme versteht und darauf antworten kann. Also Zuhören und Sprechen einfach gesagt den Tag etwas füllen. Genau darum geht es in diesem Artikel. Ich zeige, wie ich die Spracherkennung (Speech-to-Text, kurz STT) und die Sprachausgabe (Text-to-Speech, kurz TTS) für den digitalen Begleiter aufgebaut habe, warum ich dafür einen bestehenden Aufbau mit NVIDIA-Microservices wieder abgeschaltet habe und wo es gehakt hat.
Warum die Stimme der wichtigste Teil ist
Für einen Menschen mit 75 bis 90 Jahren ist das Gerät kein Bildschirm. Es ist eine Stimme. Wenn sie nicht versteht, was gesagt wurde, oder zu lange schweigt, bevor sie antwortet, ist das Interesse schnell weg. Deshalb hat die Sprachkette für mich drei wichtige Anforderungen an den aktiven Dialog:
- Gut verstehen: Deutsch, auch bei leiser oder undeutlicher Aussprache.
- Schnell antworten: Die Pause zwischen Frage und Antwort muss kurz bleiben. Das Sprachmodell braucht ohnehin seine Zeit, die Sprachdienste dürfen kaum etwas dazugeben.
- Lokal bleiben: Eine Stimmaufnahme ist ein sehr persönliches Datum. Sie verrät Stimmung, Gesundheit und oft auch, wer gerade im Raum ist. Sie verlässt das Haus nicht.
Die Ausgangslage: NVIDIA Speech-NIMs
Mein erster Aufbau lief mit den NVIDIA Speech-NIMs. Das sind fertige Container von NVIDIA mit einem Modell und einem Server darin. Für die Spracherkennung nutzte ich Parakeet (1.1b RNNT multilingual), für die Sprachausgabe Magpie TTS multilingual. Beide liefen auf meinem GPU-Server mit einer NVIDIA RTX 6000 Ada (48 GB) und haben gut funktioniert.
Im Alltag hat mich aber einiges gestört:
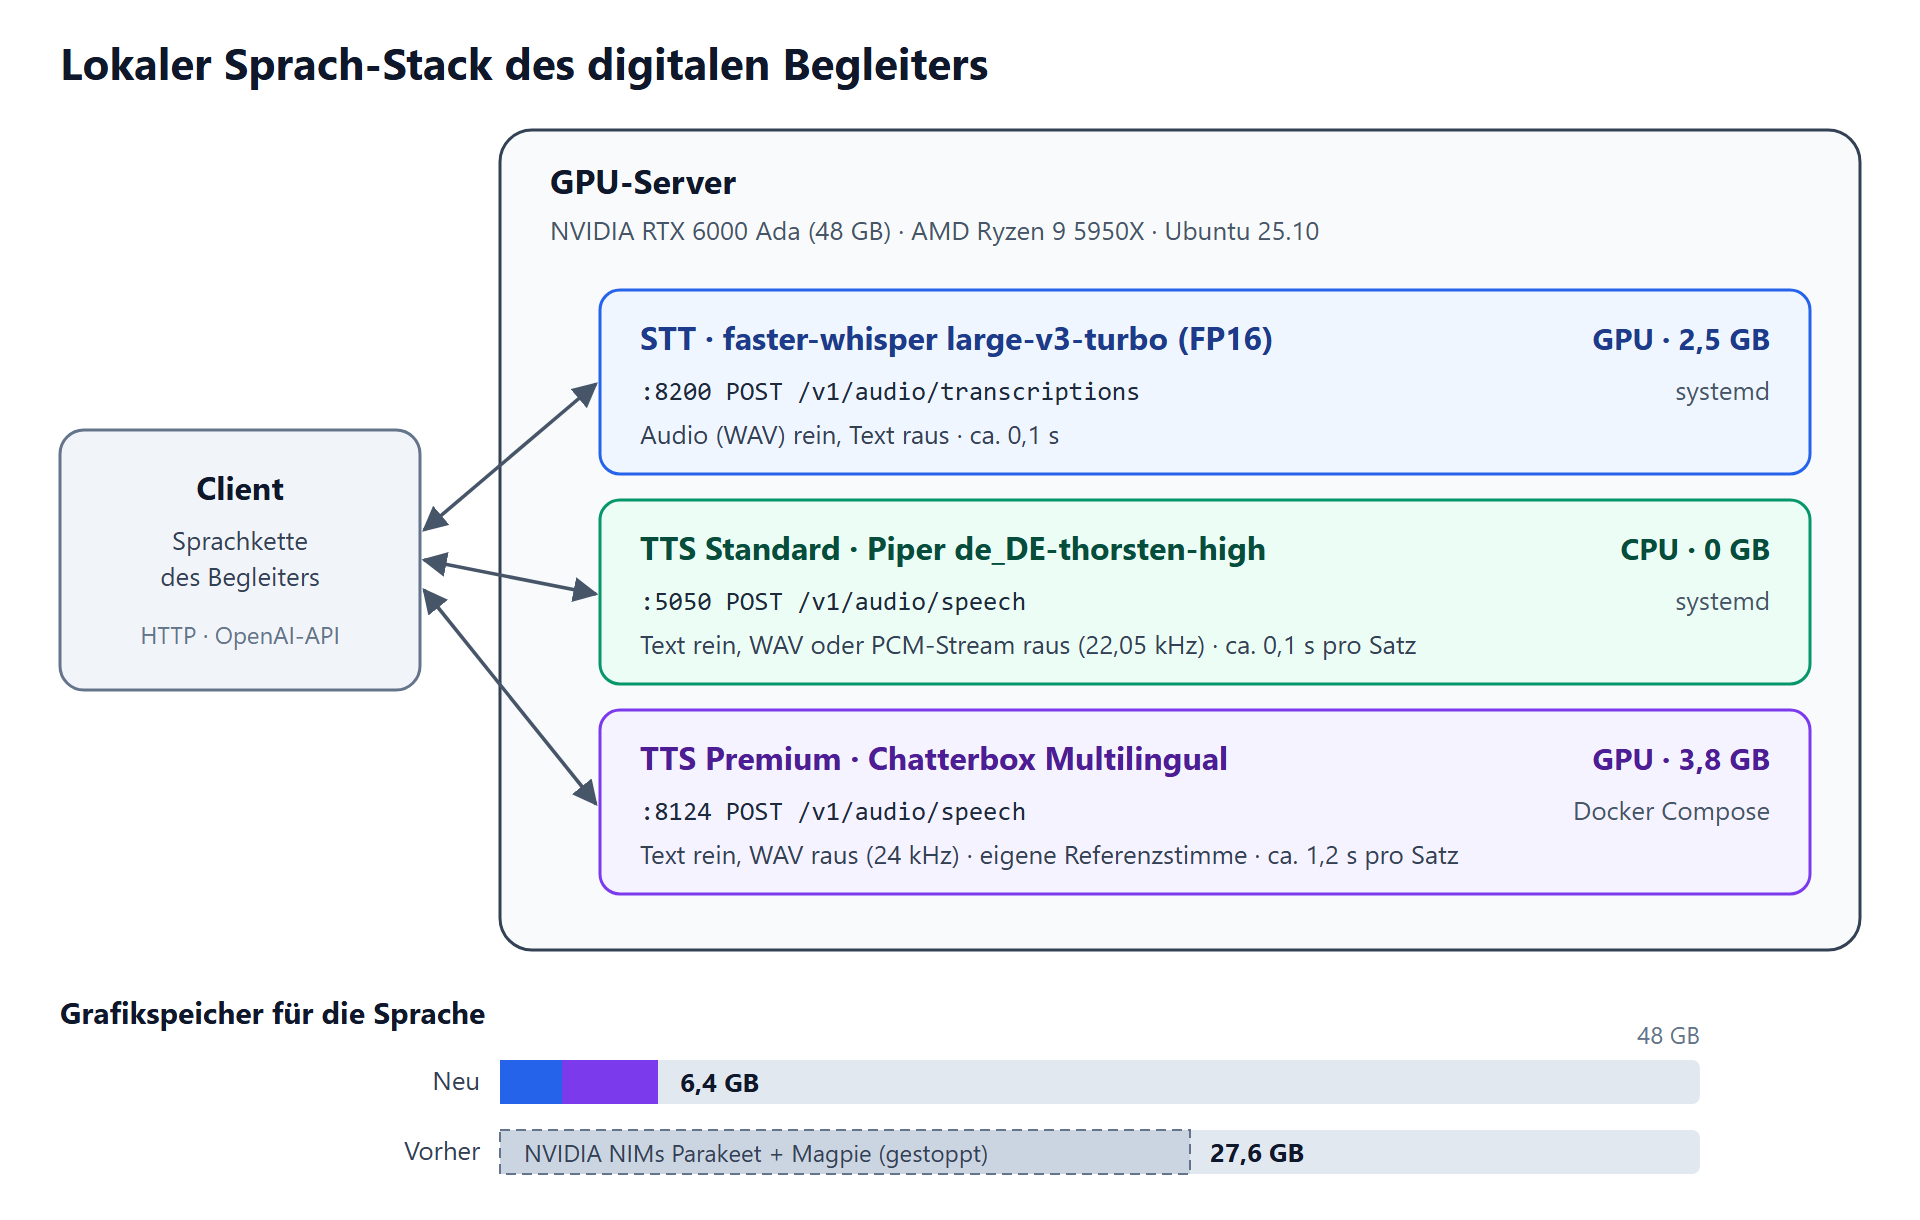
- Grafikspeicher: Parakeet belegte 14,0 GB, Magpie 13,6 GB. Zusammen 27,6 GB, also mehr als die Hälfte der Karte, nur für Hören und Sprechen.
- Größe: Jedes der beiden Images ist rund 39 GB groß.
- Schnittstelle: Die NIMs sprechen gRPC und brauchen eigene Client-Bibliotheken. Jeder Dienst hat seine eigene Art, angesprochen zu werden.
- Stimme: Eine eigene, vertraute Stimme war damit nicht einfach umzusetzen.
Auf demselben Server läuft noch mehr: der Hermes Agent, der die Gespräche steuert, ein Dokumentendienst und weitere KI-Werkzeuge. Jedes Gigabyte, das die Sprachdienste nicht belegen, steht dafür zur Verfügung.
Das Ziel: drei schlanke Dienste mit einer gemeinsamen Sprache
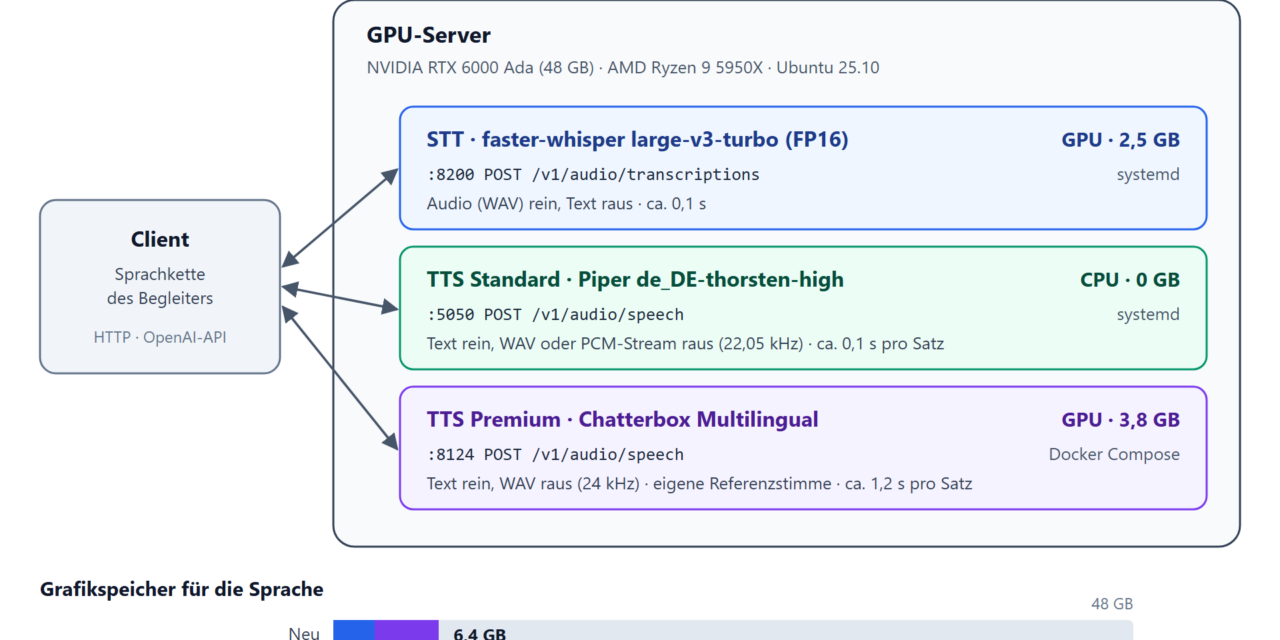
Ich habe mich für drei Open-Source-Bausteine entschieden. Alle drei bekommen eine OpenAI-kompatible HTTP-Schnittstelle. Damit sieht jeder Dienst von außen gleich aus und ist austauschbar.
| Aufgabe | Baustein | Läuft auf | Grafikspeicher |
|---|---|---|---|
| Spracherkennung (STT) | faster-whisper mit dem Modell large-v3-turbo | Grafikkarte | 2,5 GB |
| Sprachausgabe Standard | Piper mit der Stimme Thorsten | Prozessor | 0 GB |
| Sprachausgabe Premium | Chatterbox Multilingual mit eigener Referenzstimme | Grafikkarte | 3,8 GB |
Zusammen sind das 6,4 GB statt 27,6 GB. Auf der Karte sind jetzt rund 38 GB frei statt vorher 11 GB.
Wie ein Gesprächszug abläuft
Bevor ich zu den einzelnen Diensten komme, das Gesamtbild. Beteiligt sind drei Arten von Rechnern im Heimnetz:
- Das Gerät: ein 4,3-Zoll-Touchdisplay mit ESP32-S3 und Dual-Mikrofon. Es nimmt auf, spielt ab und zeigt an. Es rechnet nicht.
- Der GPU-Server: AMD Ryzen 9 5950X, RTX 6000 Ada, Ubuntu 25.10. Hier laufen der neue Sprach-Stack und der Hermes Agent.
- Der Inferenzserver: zwei RTX A6000 mit Ollama und dem Sprachmodell Qwen 3.8 27B. Der Agent fragt es an.
Ein Gesprächszug sieht so aus:
- Die Aufnahme des Geräts geht an faster-whisper. Nach rund 0,1 Sekunden kommt der Text zurück.
- Der Text geht an den Agenten, der die Antwort formuliert.
- Die Antwort wird Satz für Satz an Piper oder Chatterbox geschickt. Das Audio kommt zurück und wird auf dem Gerät abgespielt.
Ohne die Zeit des Agenten liegt die Zeit bis zum ersten Ton mit Piper bei etwa 0,2 Sekunden, mit Chatterbox bei etwa 1,3 Sekunden. Die meiste Wartezeit entsteht beim Sprachmodell, nicht bei Stimme und Gehör. Genau so wollte ich es haben.
Zuhören: faster-whisper
faster-whisper ist eine schnelle Umsetzung von Whisper, dem Spracherkennungsmodell von OpenAI. Ich nutze das Modell large-v3-turbo. Es erkennt Deutsch sehr gut und braucht auf der Grafikkarte nur 2,5 GB.
Um das Modell herum habe ich einen kleinen Webdienst gebaut. Er lädt das Modell einmal beim Start, wärmt es kurz auf und arbeitet die Anfragen nacheinander ab. Eingestellt ist er bewusst auf Tempo: Die Sprache ist fest Deutsch, und jeder Satz wird für sich erkannt. Der Begleiter hört kurze Sätze, keine langen Monologe.
Messwerte: 3 Sekunden Sprache sind nach 89 ms erkannt, 14 Sekunden nach rund 145 ms.
Sprechen, Standard: Piper
Piper ist eine schnelle Sprachsynthese, die ohne Grafikkarte auskommt und nur den Prozessor nutzt. Ich nutze die deutsche Stimme „Thorsten“ aus dem Projekt von Thorsten Müller. Sie klingt klar, ruhig und gut verständlich. Für ältere Ohren ist das wichtiger als jede Klangfarbe.
Auch hier liegt ein kleiner Webdienst davor. Er liefert das Audio entweder komplett als Datei oder als Datenstrom. Beim Datenstrom kann die Wiedergabe schon beginnen, während der Rest noch berechnet wird.
Messwerte: Ein kurzer Satz wie „Guten Morgen.“ ist nach 71 ms fertig. Deshalb ist Piper die Standardstimme.
Sprechen, Premium: Chatterbox
Chatterbox von Resemble AI ist ein neueres Sprachmodell. Die Multilingual-Variante kann 23 Sprachen, darunter Deutsch. Vor allem kann sie eine Stimme aus einer kurzen Referenzaufnahme nachbilden. Mir reichte eine Aufnahme von 23 Sekunden.
Das öffnet eine Tür, die für einen Begleiter spannend ist: eine Stimme, die vertraut klingt. Gleichzeitig ist das ein Punkt, bei dem ich vorsichtig bin. Eine Stimme nachbilden darf man nur mit dem ausdrücklichen Einverständnis der Person, der sie gehört. Und der Begleiter darf nie so tun, als sei er ein Familienmitglied.
Für Chatterbox habe ich keinen eigenen Dienst geschrieben, sondern den fertigen Chatterbox-TTS-Server von devnen genutzt. Er läuft in einem Docker-Container und bringt eine Web-Oberfläche mit. Angepasst habe ich nur wenig: das mehrsprachige Modell, Deutsch als Sprache und meine Referenzstimme. Eine neue Stimme ist einfach eine weitere Audiodatei in einem Ordner.
Messwerte: Ein Satz braucht im Mittel 1,2 Sekunden, mit einer Spanne von 0,8 bis 1,9 Sekunden. Chatterbox liefert das Audio erst, wenn der ganze Satz fertig ist. Bei langen Antworten summiert sich das. Deshalb ist Chatterbox heute die Premiumstimme und nicht die Standardstimme.
Eine Schnittstelle für alles
Alle drei Dienste verstehen dieselben Anfragen wie die Audio-Schnittstelle von OpenAI. Für die Spracherkennung schickt man eine Audiodatei und bekommt Text zurück. Für die Sprachausgabe schickt man Text und bekommt Audio. Ob dahinter Piper oder Chatterbox arbeitet, ist nur eine Frage der Adresse und des Stimmnamens.
Jedes Programm, das diese Schnittstelle kennt, kann die Dienste ohne Anpassung nutzen. Und wenn morgen ein besseres Modell erscheint, tausche ich nur einen Dienst aus.
Wie ich vorgegangen bin
Die Installation hat Claude Code für mich ausgeführt, per SSH von meinem Arbeitsrechner aus. Das wollte ich schon immer einmal probieren. Aber vorbereitet habe ich das gut mit viel Dokumentation und klaren Beschreibungen was ich erreichen möchte. Grundlage war alos eine detaillierte Arbeitsanweisung, die ich vorher geschrieben habe: mit festen Entscheidungen, mit den Bausteinen für die Dienste und mit neun Phasen von der Bestandsaufnahme bis zur Dokumentation. Nach jeder Phase hat der Agent angehalten, berichtet und auf meine Freigabe gewartet.
Drei Regeln waren mir dabei wichtig:
- Erst neu aufbauen, dann alt abschalten. Die neuen Dienste liefen zuerst parallel zu den NIMs. Der Begleiter blieb die ganze Zeit funktionsfähig.
- Nichts löschen. Die NIMs sind gestoppt und ohne Autostart, aber Images und Modell-Caches sind noch da. Ein dokumentierter Rückweg holt sie in wenigen Minuten zurück.
- Keine Rechte, die nicht nötig sind. Der Agent hatte keine Administratorrechte. Alles, was Administratorrechte brauchte, hat er mir als Befehl ausgegeben, und ich habe es selbst ausgeführt.
Ein Punkt hat mich überrascht: Die NIMs starteten automatisch mit dem Server, und ein weiterer Dienst, ein älterer Sprach-Bot, hatte die NIMs als Abhängigkeit. Hätte ich nur die NIMs gestoppt, hätte dieser Dienst sie beim nächsten Neustart wieder hochgezogen. Die Bestandsaufnahme in Phase 0 hat das gefunden. Ein Neustart des Servers nach dem Abschalten hat bestätigt: Die neuen Dienste kommen von selbst hoch, die NIMs bleiben aus.
Stolpersteine
Ganz glatt lief es nicht. Diese Punkte sollte kennen, wer etwas Ähnliches aufbaut.
Whisper erfindet Text bei Stille
Schickt man Whisper eine Aufnahme mit 0,3 Sekunden Stille, kommt „Vielen Dank.“ zurück. Das Modell wurde mit vielen Videos samt Untertiteln trainiert, und am Ende eines Videos steht oft genau so ein Satz. Bekannt sind auch Sätze wie „Untertitel im Auftrag des ZDF“. Für einen Begleiter ist das gefährlich: Er würde auf etwas antworten, das niemand gesagt hat. Wer Whisper einsetzt, sollte zu kurze und zu leise Aufnahmen gar nicht erst zur Erkennung schicken.
Fremde Bausteine passen nicht immer zusammen
Dreimal lag der Fehler nicht in meinem Aufbau, sondern zwischen Bibliotheken und deren Versionen. Eine neue Version einer Audio-Bibliothek passte nicht mehr zu faster-whisper, und jede Erkennung schlug fehl. Das Startskript fand die Bibliotheken für die Grafikkarte nicht mehr, weil sich deren Aufbau geändert hatte. Und die Vorlage des Chatterbox-Servers enthielt einen Platzhalter als Zugangsschlüssel, mit dem nicht einmal öffentliche Modelle geladen wurden. Meine Lehre daraus: Versionen festhalten, jede Abweichung notieren und nach jedem Update testen.
Kleinigkeiten mit großer Wirkung
- Sprachcode: Die NIMs wollten „de-DE“, die neuen Dienste nur „de“. Mit dem falschen Code verweigern sie die Arbeit.
- Satzzeichen: Chatterbox klingt bei Sätzen ohne Punkt am Ende manchmal abgeschnitten. Fehlende Satzzeichen vor dem Senden ergänzen.
- Aufwärmen: Nach einem Neustart braucht Chatterbox rund 11 Sekunden für den ersten Satz. Ein kurzer Satz zum Aufwärmen nach dem Start hilft.
Die Messwerte
Gemessen habe ich auf dem GPU-Server selbst. Jede Messreihe hatte sechs Läufe, den ersten habe ich verworfen, die Werte sind Mittelwerte aus fünf Läufen.
| Messung | Ziel | Ergebnis | Bewertung |
|---|---|---|---|
| STT, 3 s Sprache | < 300 ms | 89 ms | erreicht |
| Piper, ein Satz, erstes Audio (Datenstrom) | < 150 ms | 71 ms | erreicht |
| Piper, zwei Sätze komplett (Datei) | < 150 ms | 199 ms | verfehlt, misst aber zwei Sätze |
| Chatterbox, ein Satz komplett | < 1.200 ms | 1.225 ms (792 bis 1.926) | knapp verfehlt |
| Rundlauf STT + Piper, 13,9 s Sprache | – | 786 ms | |
| Rundlauf STT + Chatterbox, 13,9 s Sprache | – | 6.586 ms | langer Text ohne Streaming |
Beim Rundlauf wird eine knapp 14 Sekunden lange Aufnahme erkannt und der komplette Text wieder gesprochen. Mit Piper dauert das zusammen unter 0,8 Sekunden. Mit Chatterbox sind es 6,6 Sekunden, weil der ganze Text am Stück berechnet wird. Im echten Gespräch wird die Antwort satzweise gesprochen, dann zählt der erste Satz.
Interessant war auch der Vergleich mit und ohne laufende NIMs: Die Werte haben sich praktisch nicht verändert. Die NIMs haben also nicht gebremst. Sie haben nur Speicher belegt.
Die eingesetzten Versionen
| Baustein | Version |
|---|---|
| Betriebssystem | Ubuntu 25.10 |
| Spracherkennung | faster-whisper 1.2.1, Modell large-v3-turbo |
| Sprachausgabe Standard | Piper 1.8.0, Stimme Thorsten (high) |
| Sprachausgabe Premium | Chatterbox 0.1.6 im Chatterbox-TTS-Server |
Was noch offen ist
- Welche Stimme die Hauptstimme wird. Der Klang von Chatterbox gefällt mir. Ob 1,2 Sekunden pro Satz im Gespräch mit einem älteren Menschen stören, muss ein echter Test zeigen.
- Absicherung im Netz. Die Dienste haben keine Anmeldung und kein TLS. Sie sind nur im eigenen Netz erreichbar. Eine Firewall-Regel, die nur die berechtigten Rechner durchlässt, ist der nächste Schritt für eine minimale Sicherheit.
Mein Fazit
Der digitale Begleiter hört und spricht jetzt komplett über den neuen Stack. Er versteht gut, er antwortet schnell, und alles bleibt im Haus. Statt 27,6 GB Grafikspeicher braucht die Sprache 6,4 GB. Und statt zwei großer, geschlossener Container habe ich drei kleine Dienste, die ich verstehe und einzeln austauschen kann.
Die NIMs waren kein Fehler. Sie haben mir geholfen, schnell einen ersten funktionierenden Aufbau zu haben. Für ein System, das jahrelang in einem Wohnzimmer laufen soll, will ich aber Bausteine, die ich selbst warten kann.
Die Technik ist damit nicht der schwierigste Teil. Das bleibt das Gesprächsdesign: wie langsam der Begleiter spricht, wie geduldig er wartet, wie er nachfragt, ohne zu bevormunden. Eine schnelle Stimme hilft dabei nur, wenn sie zum richtigen Zeitpunkt das Richtige sagt.
Stand und Quellen
Stand: Oktober 2026. Alle Messwerte stammen aus meinem eigenen Aufbau und lassen sich nicht ohne Weiteres auf andere Hardware übertragen.
- Erster Teil der Reihe: Warum ich mir einen digitalen Begleiter selbst baue
- faster-whisper: github.com/SYSTRAN/faster-whisper
- Piper: github.com/OHF-Voice/piper1-gpl, Stimmen: huggingface.co/rhasspy/piper-voices
- Chatterbox: github.com/resemble-ai/chatterbox
- Chatterbox-TTS-Server: github.com/devnen/Chatterbox-TTS-Server
Hinweis: Dieser Artikel beschreibt ein privates Projekt. Er ist keine Anleitung für den Einsatz in der Pflege. Wer Stimmen nachbildet oder Sprachaufnahmen anderer Menschen verarbeitet, braucht deren Einverständnis und sollte sich im Zweifel rechtlich beraten lassen.




Ein toller Guide der leicht zugänglich und verständlich ist. Perfekt für ein kleines Side-Project geeignet. Aktuell half mir noch mein…
Thank you for this great tutorial, could you share n8n workflow and comfyui workflow please?
Hallo Anton, die Meldung besagt das in meinem Beisiel Methoden verwendet werden die veraltet (deprecated) sind. Also müsstest Du die…
Danke für das Tool! Ich habe erst kürzlich angefangen mich mit der Thematik zu beschäftigen und bin für meine Erwartungen…
Hallo, ich habe ihre Anleitung befolgt und bekomme im letzten Schritt leider immer folgende Meldung im Terminal: bash <(wget -qO-…